Per usare l’intelligenza artificiale nel lavoro non serve un PC da gaming con una scheda video da mille euro e non serve caricare ogni contratto o fattura sul cloud di qualcun altro. Un mini PC grande come una tazza basta per avere in ufficio un assistente che risponde senza internet, un programma che archivia i documenti al posto nostro, qualche automazione e un ambiente per programmare con che usa l’AI.
Lo abbiamo testato passo dopo passo e qui raccontiamo come, con i numeri che abbiamo misurato. La macchina è il GEEKOM IT12 2026 Edition nella versione più accessibile, con Core i3, 16 GB di RAM e SSD da 256 GB. Non è un mostro di potenza ed è proprio questo il punto! Continuate a leggere per saperne di più.
Cosa intendiamo per «workstation AI»
Tre parole torneranno spesso. Un modello locale è un’intelligenza artificiale più piccola di ChatGPT che gira sul computer: domande e documenti non escono da casa nostra. Un agente è un programma che usa l’AI per fare qualcosa, non solo per rispondere: legge un file, decide dove metterlo, lo sposta. Un’automazione è una sequenza di passaggi che parte da sola, per esempio quando arriva un file in una cartella. La workstation AI è il computer che mette insieme le tre cose e resta a disposizione di tutta la casa o dell’ufficio.
Il Mini PC che abbiamo usato: GEEKOM IT12 2026
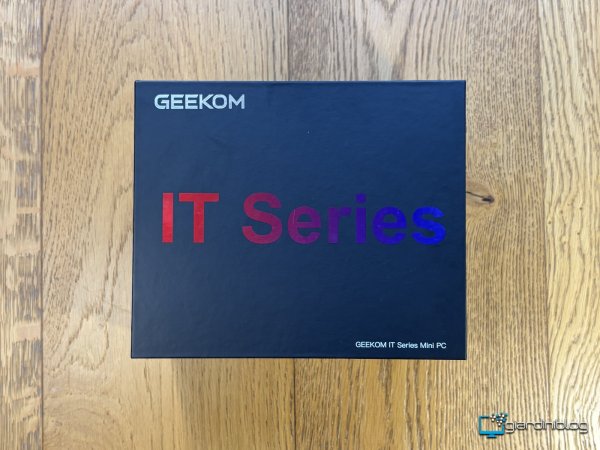
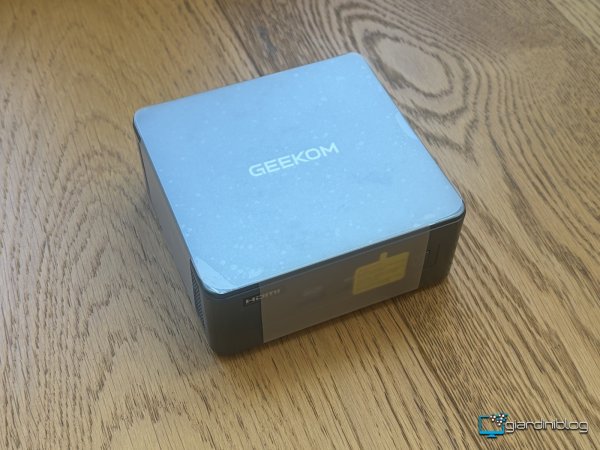
Ecco una panoramica del Geekom IT12 2026 con unboxing e contenuto della confezione.
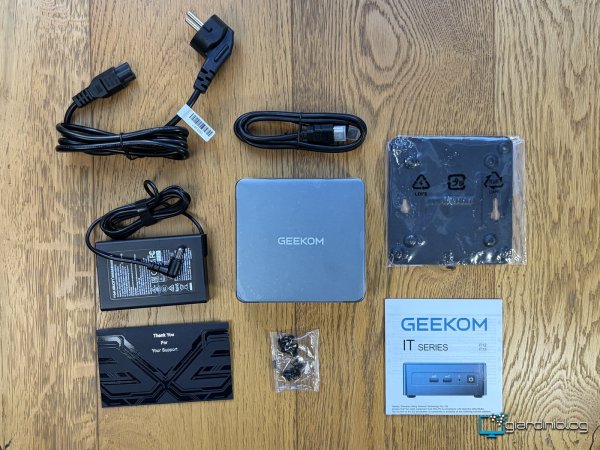
| Componente | Nell’unità in prova |
|---|---|
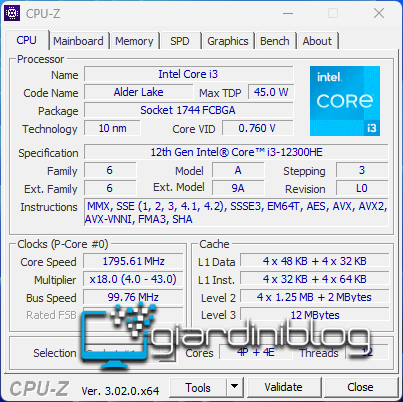
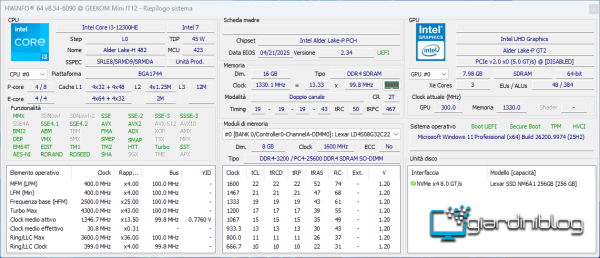
| Processore | Intel Core i3-12300HE (12ª gen., Alder Lake): 8 core (4 Performance + 4 Efficient), 12 thread, fino a 4,3 GHz |
| Memoria | 16 GB DDR4-3200 SO-DIMM, 2 moduli da 8 GB in dual channel, sostituibili |
| Archiviazione | SSD NVMe Lexar da 256 GB |
| Grafica | Intel UHD Graphics integrata (48 unità di calcolo) |
| Sistema | Windows 11 Pro |
| Porte | 2 USB4, 2 HDMI, 4 USB-A, Ethernet 2,5G, lettore SD, jack audio |
| Espandibilità (dati GEEKOM) | Oltre all’SSD principale, uno slot M.2 2242 SATA e un alloggiamento 2,5″ SATA; fino a 7 TB in totale |
| Dimensioni | 117 × 112 × 49 mm |
Per il nostro uso conta soprattutto lo spazio. I tre modelli AI che abbiamo provato pesano circa 10 GB in tutto e tra Docker, sviluppo e documenti i 256 GB dell’SSD si riempiono in fretta. I due alloggiamenti liberi permettono di montare un secondo disco dentro il case, senza box esterni appesi alle USB.
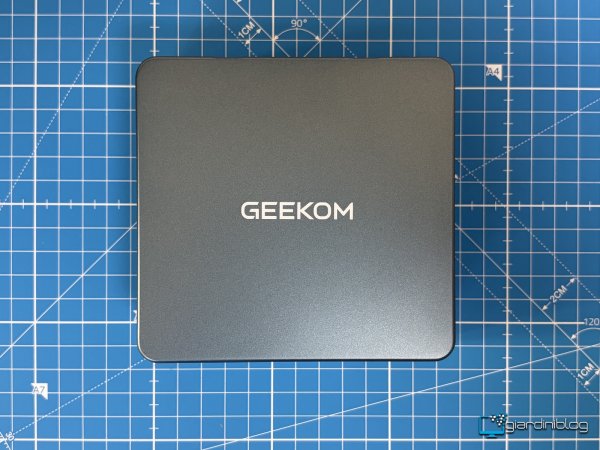
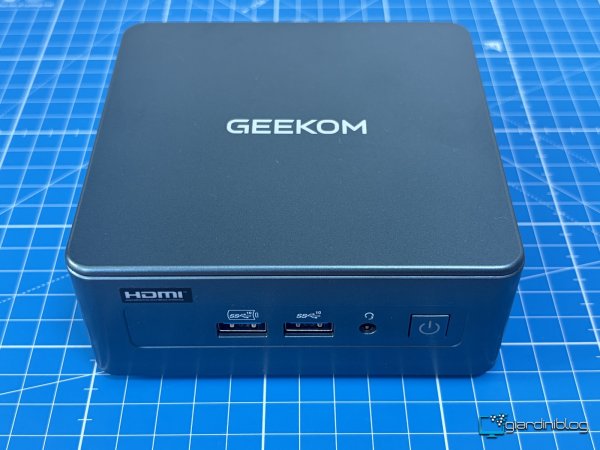
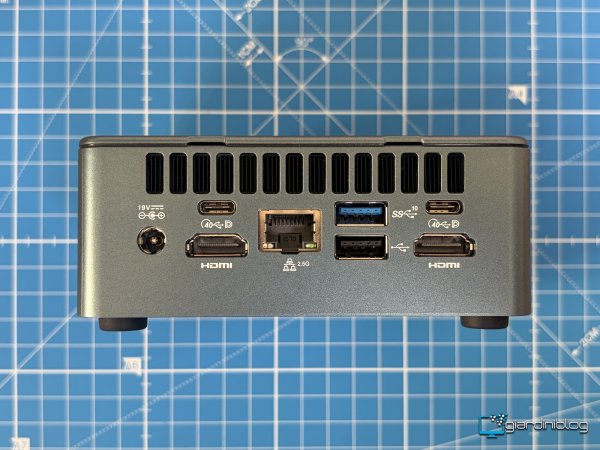
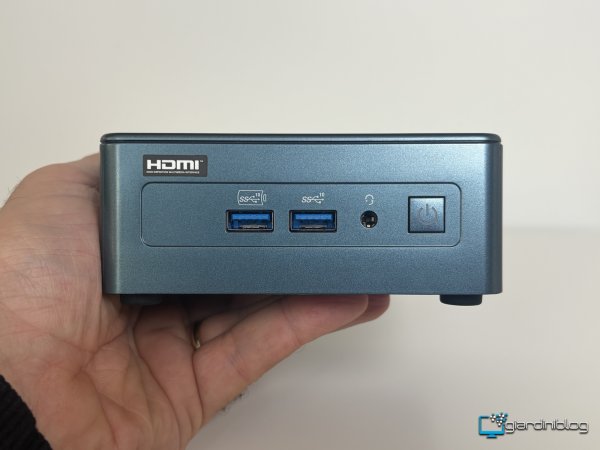
Sulla costruzione ci affidiamo ai dati del produttore: secondo GEEKOM il telaio regge 300 kg, ogni unità passa 339 controlli in fabbrica e i test ESD/EMC (scariche elettrostatiche e interferenze), il raffreddamento usa un dissipatore in rame e la garanzia è di 3 anni. Noi abbiamo verificato che il fondo si apre con quattro viti e che memoria e SSD sono subito raggiungibili. Una comodità ulteriore è che la prima configurazione di Windows si completa senza internet e senza account Microsoft.
Passo 1: l’assistente AI privato con Ollama
Il primo mattone è Ollama, un programma gratuito che scarica i modelli AI e li fa girare sul computer. Si installa come qualsiasi altro software per Windows; poi gli si parla dalla sua app, che somiglia a una normale chat, oppure dal terminale con un comando come ollama run gemma3:4b.
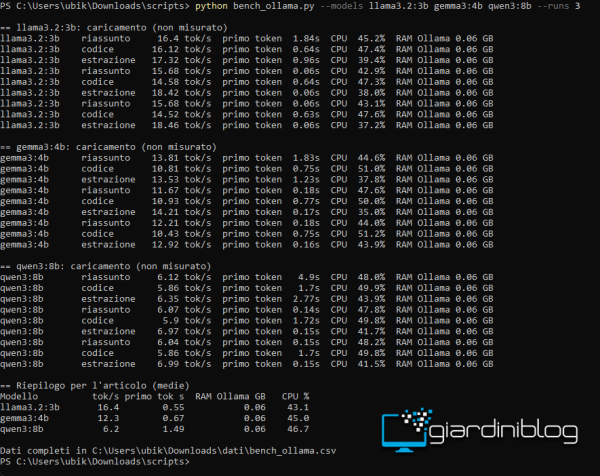
Le sigle «3B», «4B» o «8B» indicano quanti miliardi di parametri ha il modello, cioè quanti «collegamenti» ha imparato durante l’addestramento: più sono, più il modello è capace, ma anche lento e affamato di memoria. Abbiamo provato tre modelli su tre compiti (un riassunto, un pezzo di codice, l’estrazione di dati da un testo), ripetendo ogni prova tre volte.
| Modello | Velocità di scrittura | RAM del PC occupata (picco) | Per cosa va bene |
|---|---|---|---|
| Llama 3.2 3B | 16,4 token/s | circa 9 GB | risposte rapide, riassunti brevi |
| Gemma 3 4B | 12,3 token/s | circa 12 GB | il miglior compromesso, buono in italiano |
| Qwen3 8B | 6,2 token/s | circa 15 GB | più accurato, ma lento e al limite dei 16 GB |
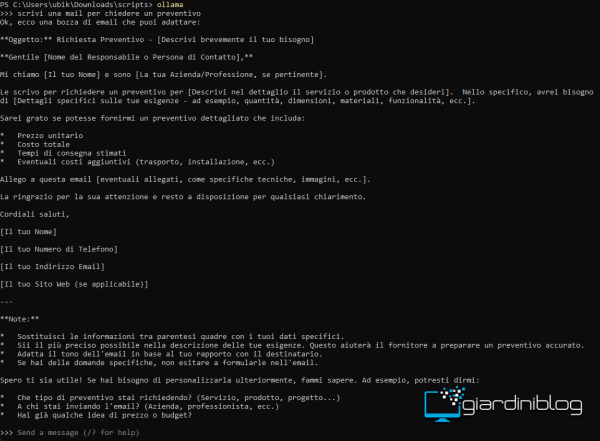
Per l’uso quotidiano abbiamo scelto Gemma 3 4B: scrive in un italiano naturale, non fa aspettare e lascia memoria libera per il resto. Gli abbiamo chiesto una mail per domandare un preventivo a un fornitore e ne è uscita una bozza completa, con oggetto, saluti e i dati da aggiungere tra parentesi: da adattare in due minuti.
Senza una scheda video dedicata l’AI gira sul processore e i modelli che si possono usare sono quelli piccoli. Vanno bene per riassumere, classificare, estrarre dati e preparare bozze; per un ragionamento lungo, un testo complesso o un’analisi approfondita ChatGPT, Claude o Gemini restano comunque più capaci. Non serve scegliere: il modello locale su Geekom IT12 si occupa dei documenti riservati e dei lavori ripetitivi, il cloud di tutto il resto.
Passo 2: l’agente che mette in ordine i documenti
Qui l’AI smette di essere solo una chat e comincia a lavorare; abbiamo scritto un piccolo agente che fa il monitoraggio di una cartella: quando arriva un documento lo legge, lo riassume, decide la categoria, aggiunge una riga a un foglio Excel di riepilogo e sposta il file nella cartella giusta. Tutto in locale, con Gemma 3 4B e senza pagare nulla a nessun fornitore. Il cuore sta in poche righe: si chiede a Ollama una risposta in JSON, cioè dati strutturati che il programma legge senza dover interpretare frasi.
import requests, json

prompt = f"""Leggi il documento e rispondi solo in JSON con due campi:
categoria (fattura, preventivo, nota spese, report, documentazione tecnica,
voce enciclopedica, altro) e riassunto (massimo due frasi).
Documento:
{testo}"""

r = requests.post("http://localhost:11434/api/generate", json={
"model": "gemma3:4b", "prompt": prompt, "format": "json", "stream": False})
dati = json.loads(r.json()["response"])
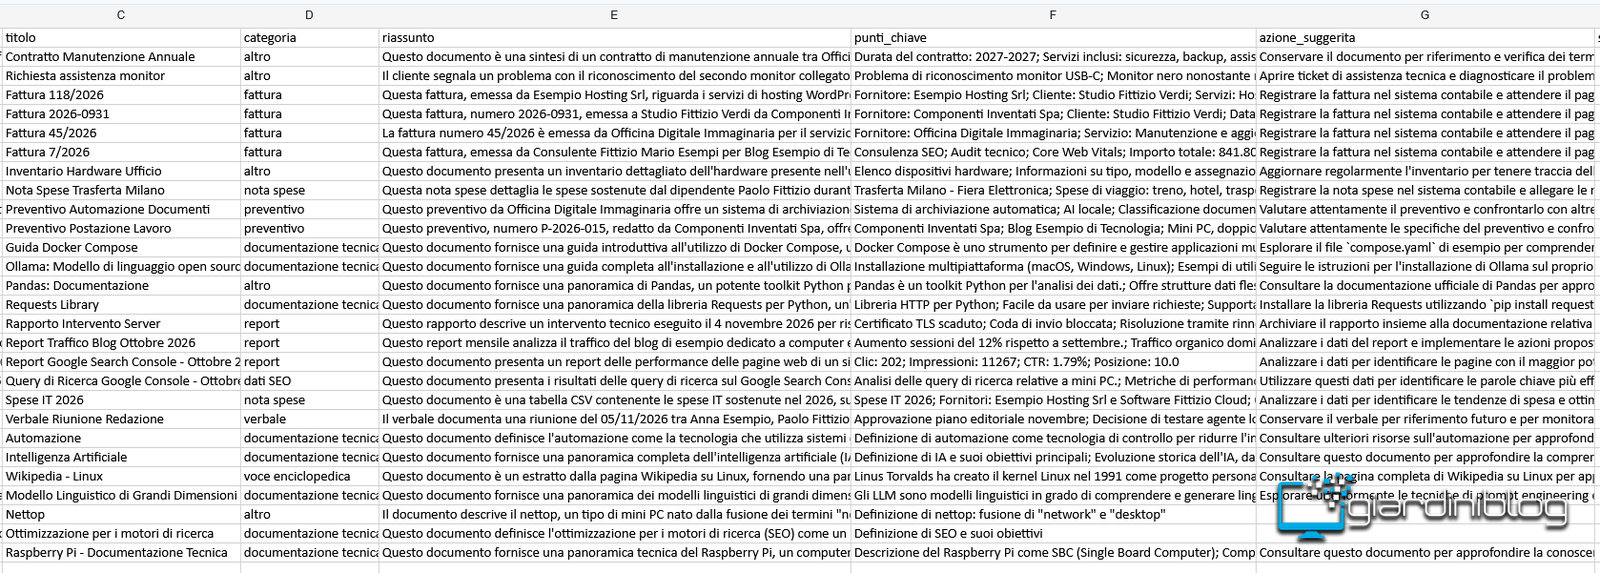
Lo abbiamo messo alla prova con 27 documenti di natura molto diversa: fatture, preventivi, note spese, report, export di Google Search Console, voci di Wikipedia e documentazione tecnica. I documenti brevi, come una fattura o un preventivo, vengono elaborati in 20-26 secondi l’uno; quelli lunghi, come una guida o una voce enciclopedica di circa 2.000 token, richiedono tra 36 e 81 secondi. Durante il lavoro il modello scrive a 10-13 token al secondo.
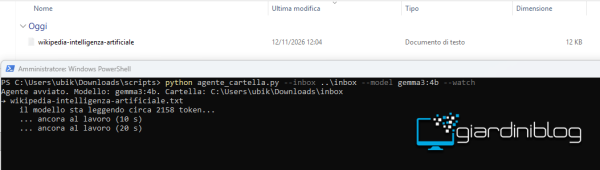
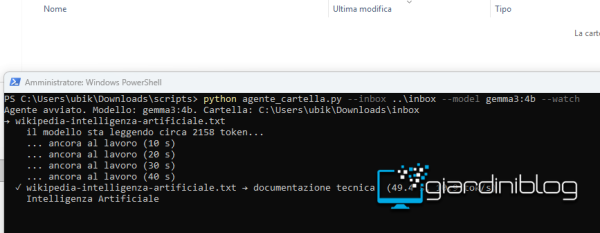
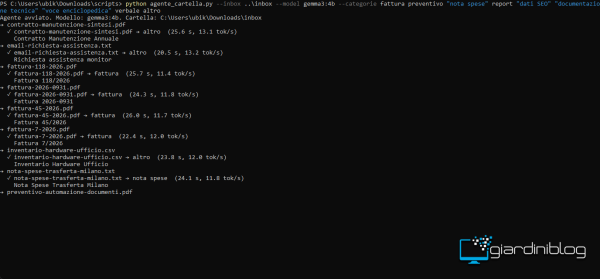
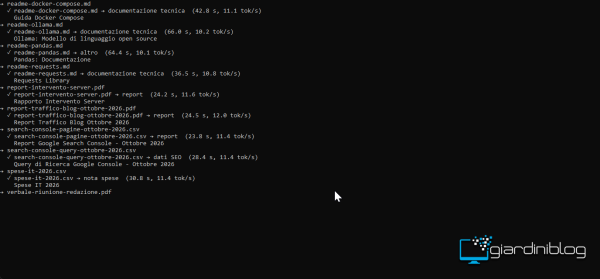
Circa due documenti su tre sono finiti nella categoria giusta, tra cui tutte le fatture, tutti i preventivi, la nota spese, i report e il verbale di riunione. Gli errori stanno dove anche una persona potrebbe esitare: quasi tutte le voci di Wikipedia archiviate come «documentazione tecnica» invece che «voce enciclopedica», un export di Search Console diventato «report», un foglio di spese informatiche scambiato per una «nota spese». Una volta il modello si è «incantato» ripetendo le stesse parole; l’agente se n’è accorto perché la risposta non era un JSON valido, ha riprovato e il secondo tentativo è andato a buon fine.
Con documenti dalla struttura chiara, come fatture e preventivi, l’agente si può già usare tutti i giorni. Sulle categorie che si somigliano un modello da 4 miliardi di parametri sbaglia più spesso, e un’occhiata al riepilogo in Excel a fine giornata è d’obbligo.
Passo 3: automazioni senza programmare con n8n
Lo script dell’agente richiede un minimo di familiarità con il codice. Per il resto c’è n8n, che costruisce automazioni collegando dei blocchi sullo schermo. Lo abbiamo installato in Docker Desktop, che crea un «contenitore»: una scatola chiusa in cui n8n gira separato da Windows, senza sporcare il sistema. Si avvia in pochi secondi e occupa circa 420 MB di RAM.
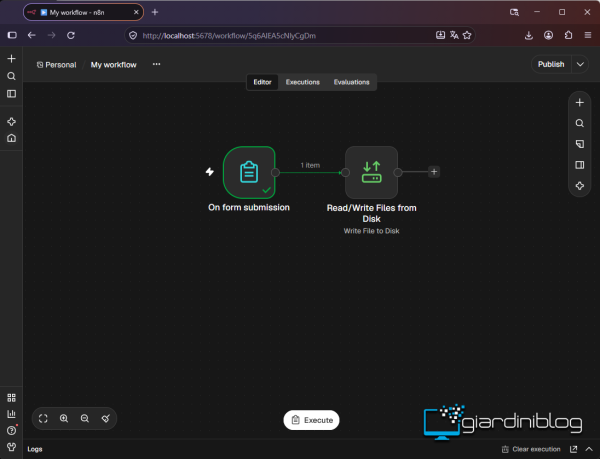
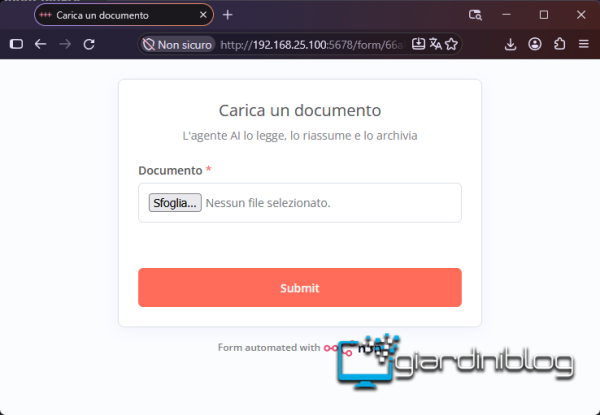
Il nostro flusso ha due blocchi: il primo pubblica una pagina web con un modulo per caricare un documento, il secondo salva il file nella cartella sorvegliata dall’agente. Il resto lo fa l’agente e il riepilogo in Excel si aggiorna da solo. Il modulo si apre da qualunque computer della rete: lo abbiamo usato da un altro PC digitando l’indirizzo nel browser e così un collega può caricare una fattura senza toccare il mini PC Geekom.
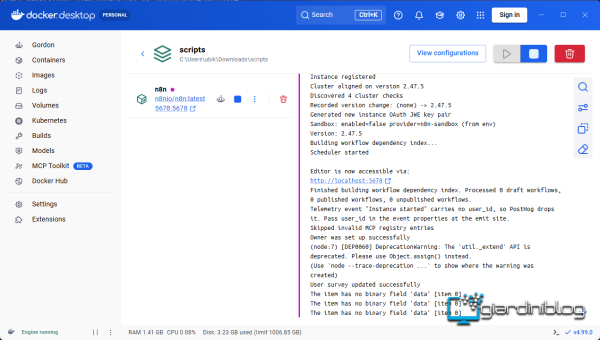
Lo stesso schema si presta a molte varianti: n8n ha blocchi già pronti per leggere una casella di posta e farne riassumere i messaggi a Ollama, per preparare un report ogni lunedì mattina o per mandare un avviso su Telegram quando nella cartella arriva una fattura.
Passo 4: programmare con l’AI accanto
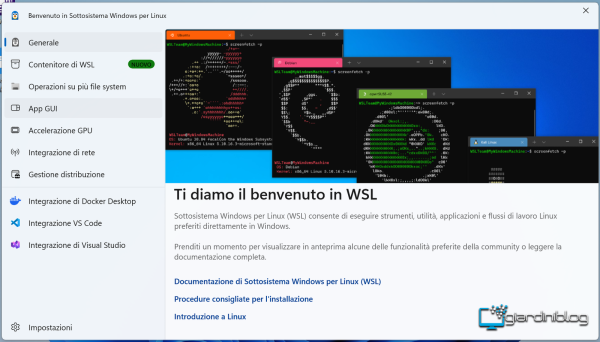
L’ultimo tassello è per chi scrive codice, anche solo qualche script. Abbiamo installato VS Code, l’editor gratuito di Microsoft, WSL2, cioè un vero Linux dentro Windows che si avvia in pochi secondi, e l’estensione Continue, che collega l’editor allo stesso Ollama. Abbiamo selezionato una funzione dello script dell’agente e chiesto di spiegarla e di aggiungere il supporto ai file Word: risposta corretta, con la spiegazione e il codice già modificato.
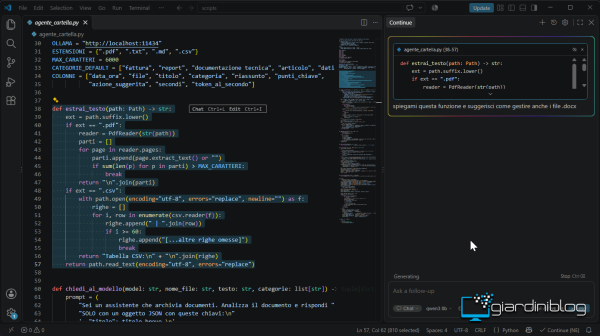
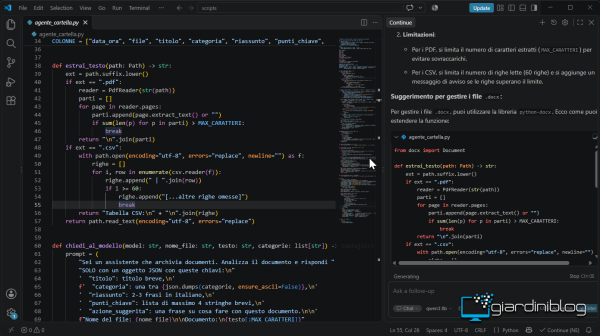
Qui abbiamo usato Qwen3 8B, il più accurato dei tre e la risposta arriva in diversi secondi: va benissimo per farsi spiegare il codice o chiedere una modifica, mentre per i suggerimenti mentre si scrive conviene un modello più piccolo. Quello che succede è che i propri progetti, magari proprio codice per un cliente, non lasciano mai il computer.
Come lavora il Mini PC Geekom IT12
Durante le prove abbiamo usato il mini PC Geekom IT12 quasi sempre da un portatile, con il Desktop remoto di Windows 11 Pro (la versione Home si collega ad altri PC ma non può essere controllata). Il desktop del mini PC compare in una finestra e si lavora come se fossimo seduti davanti, quindi la workstation può stare in un angolo o dietro il monitor, con la staffa VESA inclusa. Insieme al modulo di n8n diventa un piccolo «cervello» condiviso: ognuno usa l’AI dal proprio computer e i dati restano in un posto solo.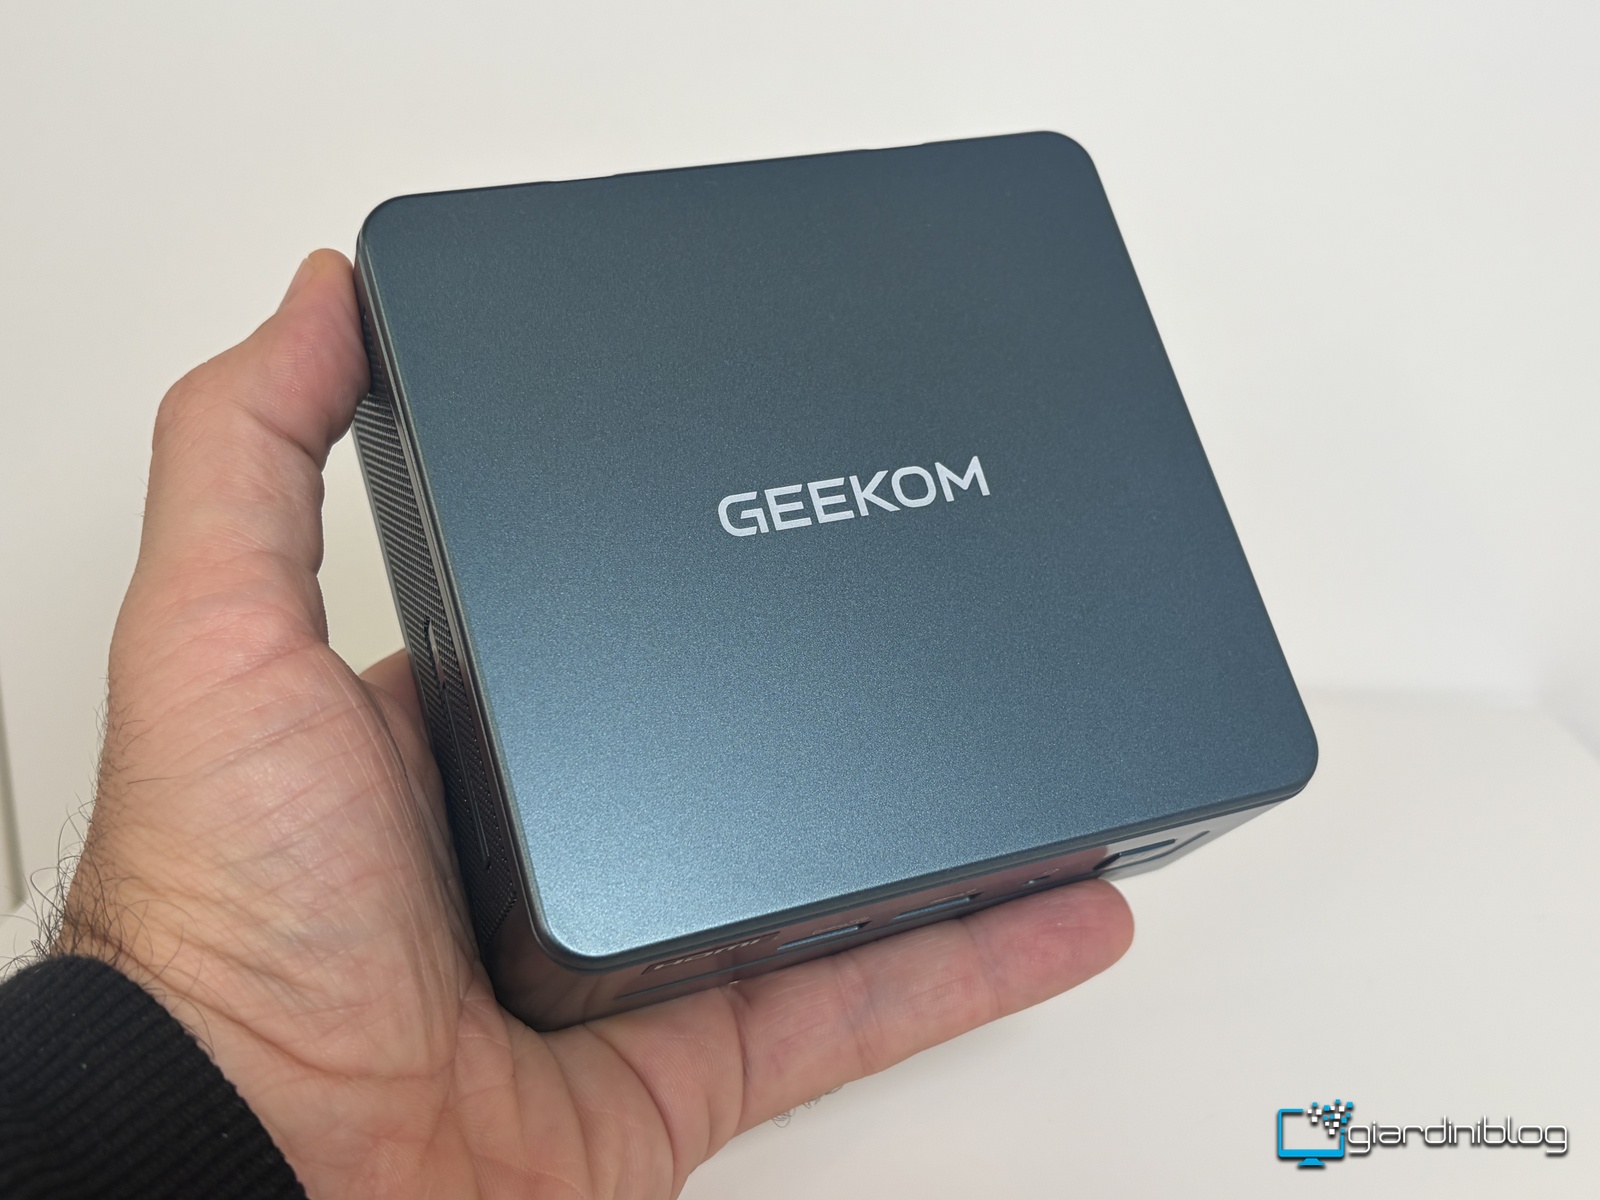
CPU del Mini PC Geekom IT12
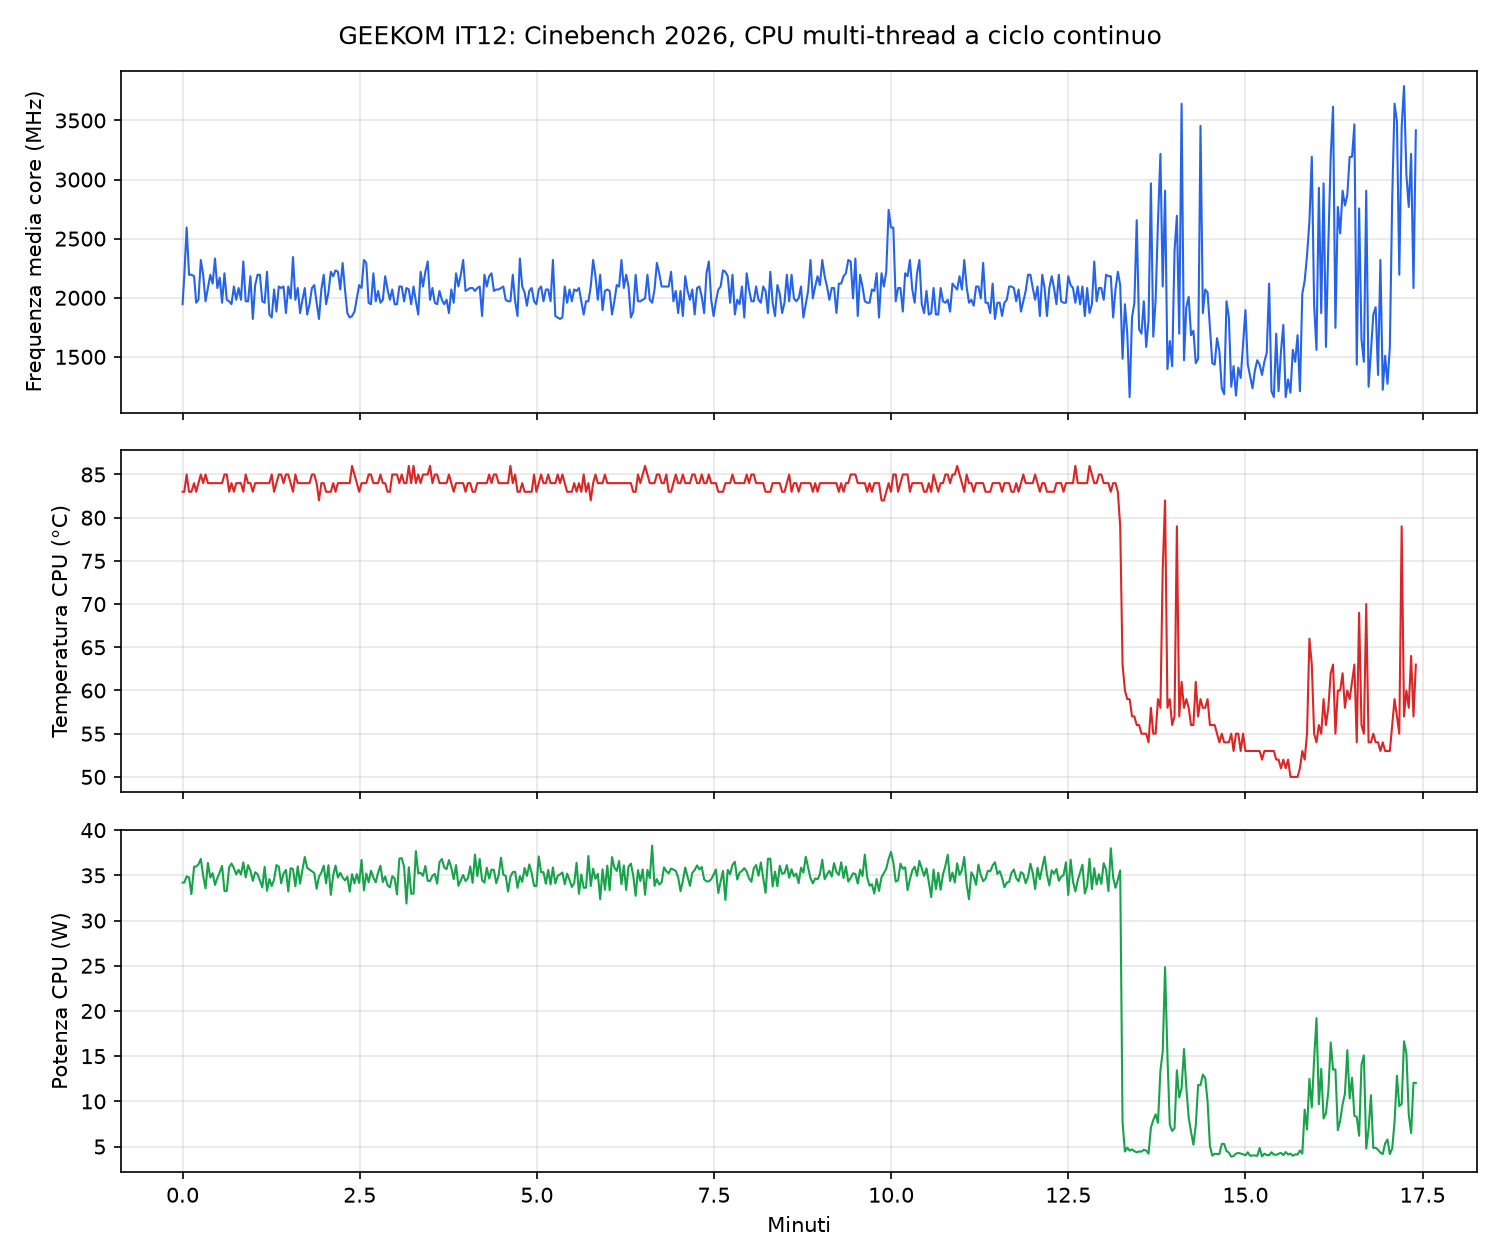
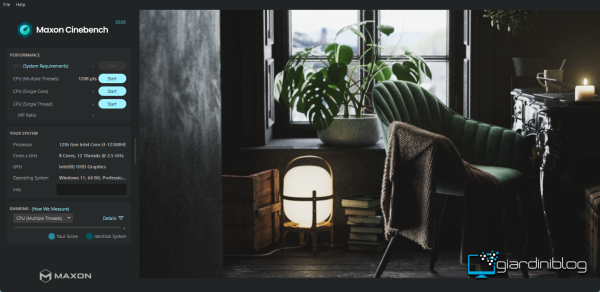
Un mini PC che rallenta dopo dieci minuti di lavoro non serve a molto. Nella prima prova abbiamo fatto girare Cinebench in ciclo continuo, registrando per circa 13 minuti potenza, temperatura e frequenza con HWiNFO. GEEKOM dichiara per il processore una potenza fino a 45 W; nella nostra unità, sotto carico continuo, il processore si è assestato intorno ai 35 W dal primo all’ultimo minuto, con picchi a 38 W. La temperatura è rimasta ferma a 84 °C (massimo 86 °C) e la frequenza media non è scesa nel tempo. Il thermal throttling, cioè il rallentamento automatico del processore quando scalda troppo, è comparso in un solo campione su tutta la registrazione, lo 0,2% del tempo.
A limitare il processore è il tetto di potenza impostato in fabbrica per il lavoro prolungato, non il calore: il raffreddamento ha ancora tranquillamente del margine. Sulla rumorosità non abbiamo fatto misure strumentali ma la ventola è rimasta silenziosa nella maggior parte delle situazioni e test a cui abbiamo sottoposto Geekom IT12.
Una giornata di lavoro completa
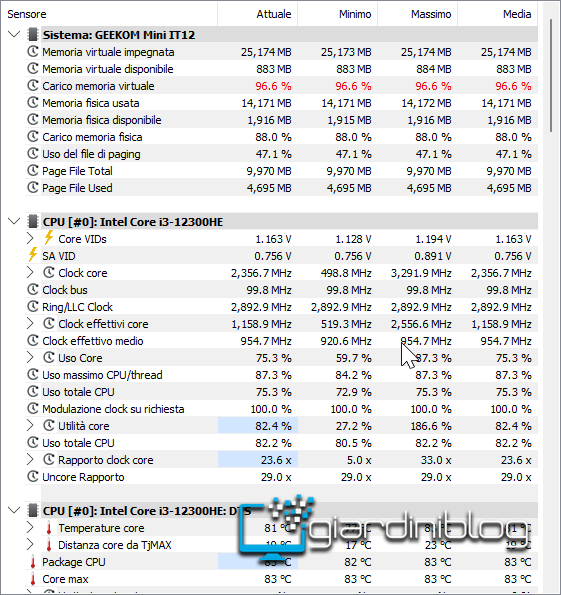
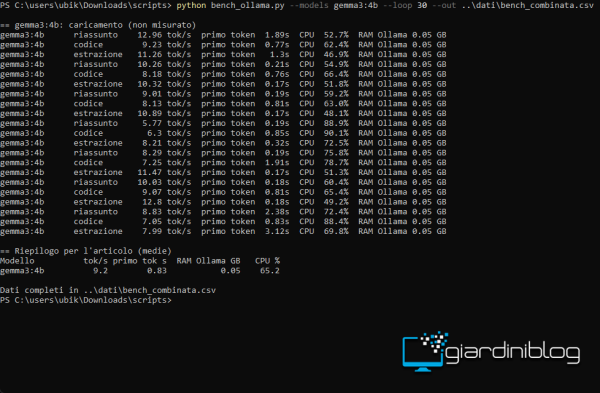
La seconda prova è più vicina all’uso reale: per 30 minuti abbiamo fatto compilare del software in ciclo dentro Linux e, contemporaneamente, abbiamo tenuto Gemma 3 a scrivere senza sosta. L’AI non si è fermata: ha mantenuto 9,2 token al secondo di media contro i 12,3 a computer libero, con punte minime intorno ai 6. La temperatura del processore è rimasta tra 81 e 89 °C.
La vera strozzatura, in questo scenario, è la memoria. Con AI, compilazione e Docker aperti insieme siamo arrivati a circa 15 GB occupati su 16, il 95%. Per chi pensa di usare il mini PC così tutti i giorni, il primo aggiornamento da fare è la RAM: entrambi gli slot sono occupati da moduli da 8 GB, quindi per salire a 32 GB si sostituiscono con due moduli da 16 GB. Bastano un cacciavite e pochi minuti a disposizione.
| Cinebench 2026, CPU multi-thread | 1.208 punti |
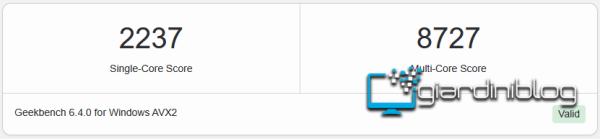
| Geekbench 6.4, single-core / multi-core | 2.237 / 8.727 |
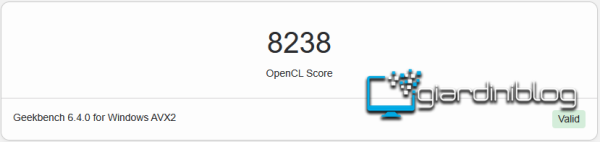
| Geekbench 6.4, GPU (OpenCL) | 8.238 |
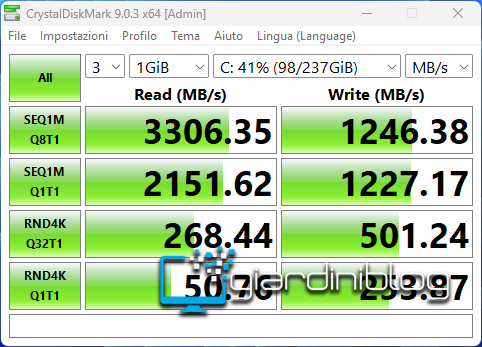
| CrystalDiskMark, lettura / scrittura sequenziale | 3.306 / 1.246 MB/s |
| CrystalDiskMark, lettura / scrittura 4K casuale (Q1T1) | 51 / 254 MB/s |
| Carico prolungato: potenza / temperatura | circa 35 W / 84 °C, stabili |
Risultati online di Geekbench: CPU e GPU.
Considerazioni su workstation AI con Geekom IT12
Il processore conta meno di quanto pensiamo. Un moderno 8 core come il Core i3-12300HE regge modelli da 3-4 miliardi di parametri, n8n, Docker e un ambiente di sviluppo e il nome «i3» inganna: dopo una settimana di uso d’ufficio fianco a fianco con un Intel Core i7 le due macchine non si distinguevano e in single-core del PC fisso risulta più veloce ma nemmeno di tanto.
La RAM è il parametro da guardare per primo; 16 GB sono il minimo e, come abbiamo visto, si arriva al limite quando AI, Docker e sviluppo lavorano insieme; con 32 GB si sta comodi anche con i modelli da 8 miliardi di parametri. Che i moduli siano sostituibili, come sull’IT12, non è un dettaglio: su molti mini PC recenti la memoria è saldata.
Il disco deve poter crescere, perché modelli e container occupano decine di gigabyte. Su Geekom IT12 la via più semplice è l’alloggiamento da 2,5 pollici, dove va un normale SSD SATA da 1 o 2 TB; lo slot M.2 2242 SATA è un’opzione in più ma gli SSD in quel formato sono meno comuni.
Porte e rete pesano nell’uso quotidiano: due monitor vanno direttamente sulle HDMI e le USB4 ne aggiungono altri due, mentre l’Ethernet a 2,5 gigabit rende rapidi il Desktop remoto e i caricamenti dagli altri PC. Il raffreddamento, deve tenere le prestazioni costanti per ore e nelle nostre prove Geekom IT12 non ha mai rallentato a causa del calore.
Resta il limite di fondo: senza una scheda video dedicata i modelli grandi, quelli per intenderci da 14 miliardi di parametri in su, sono troppo lenti. Per quelli serve un’altra classe di macchina, oppure il direttamente cloud. Le USB4 lasciano però aperta una strada: Geekom IT12 funziona con un box eGPU, cioè una scheda video esterna collegata via cavo e quindi in teoria si può anche dotarlo di una GPU se vogliamo proprio spingerci oltre.
Conclusioni
Progettare una workstation AI oggi è alla portata di chiunque sappia installare un qualsiasi software. Ollama, un agente per i documenti, n8n e VS Code con Continue sono gratuiti, e insieme danno un assistente privato, un archivio che si ordina da solo, automazioni raggiungibili da tutta la rete e un aiuto concreto per chi programma, senza che un documento lasci l’ufficio.
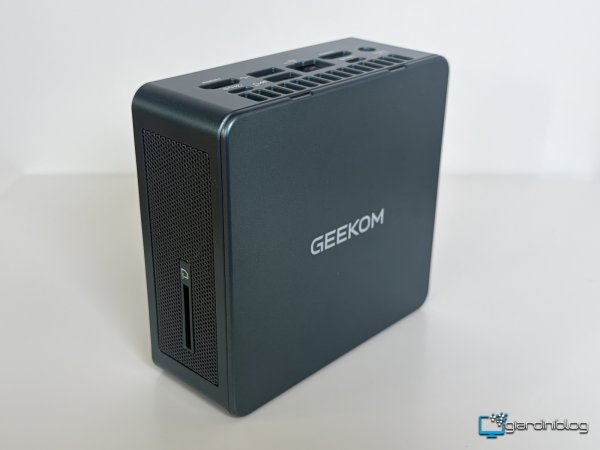
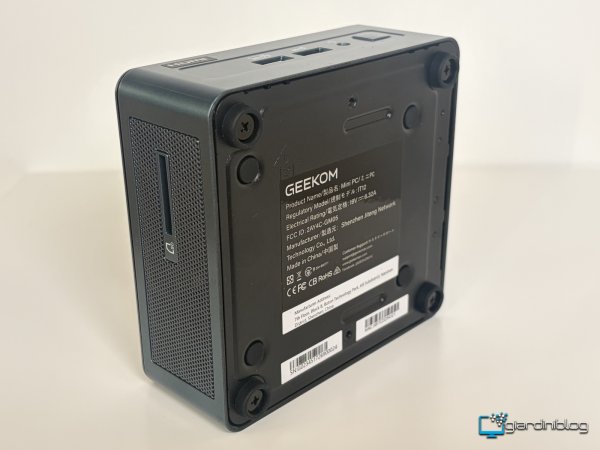
GEEKOM IT12 si è dimostrato una base adatta anche nella versione più economica con CPU Core i3: stabile sotto carico per tutto il tempo, ricco di porte, grande meno di un libro e con lo spazio interno per crescere. Il limite principale sono i 16 GB di RAM, sufficienti per assistente e agente ma stretti se si tiene aperto tutto insieme: il passaggio a 32 GB va messo in conto.
Lo consigliamo a professionisti, piccoli uffici e sviluppatori che vogliono usare l’AI sui propri dati senza mandarli in cloud. Chi cerca modelli grandi o vuole giocare dovrà guardare a mini PC con grafica più potente, come quelli con Ryzen e Radeon integrata o a un desktop con scheda video dedicata.
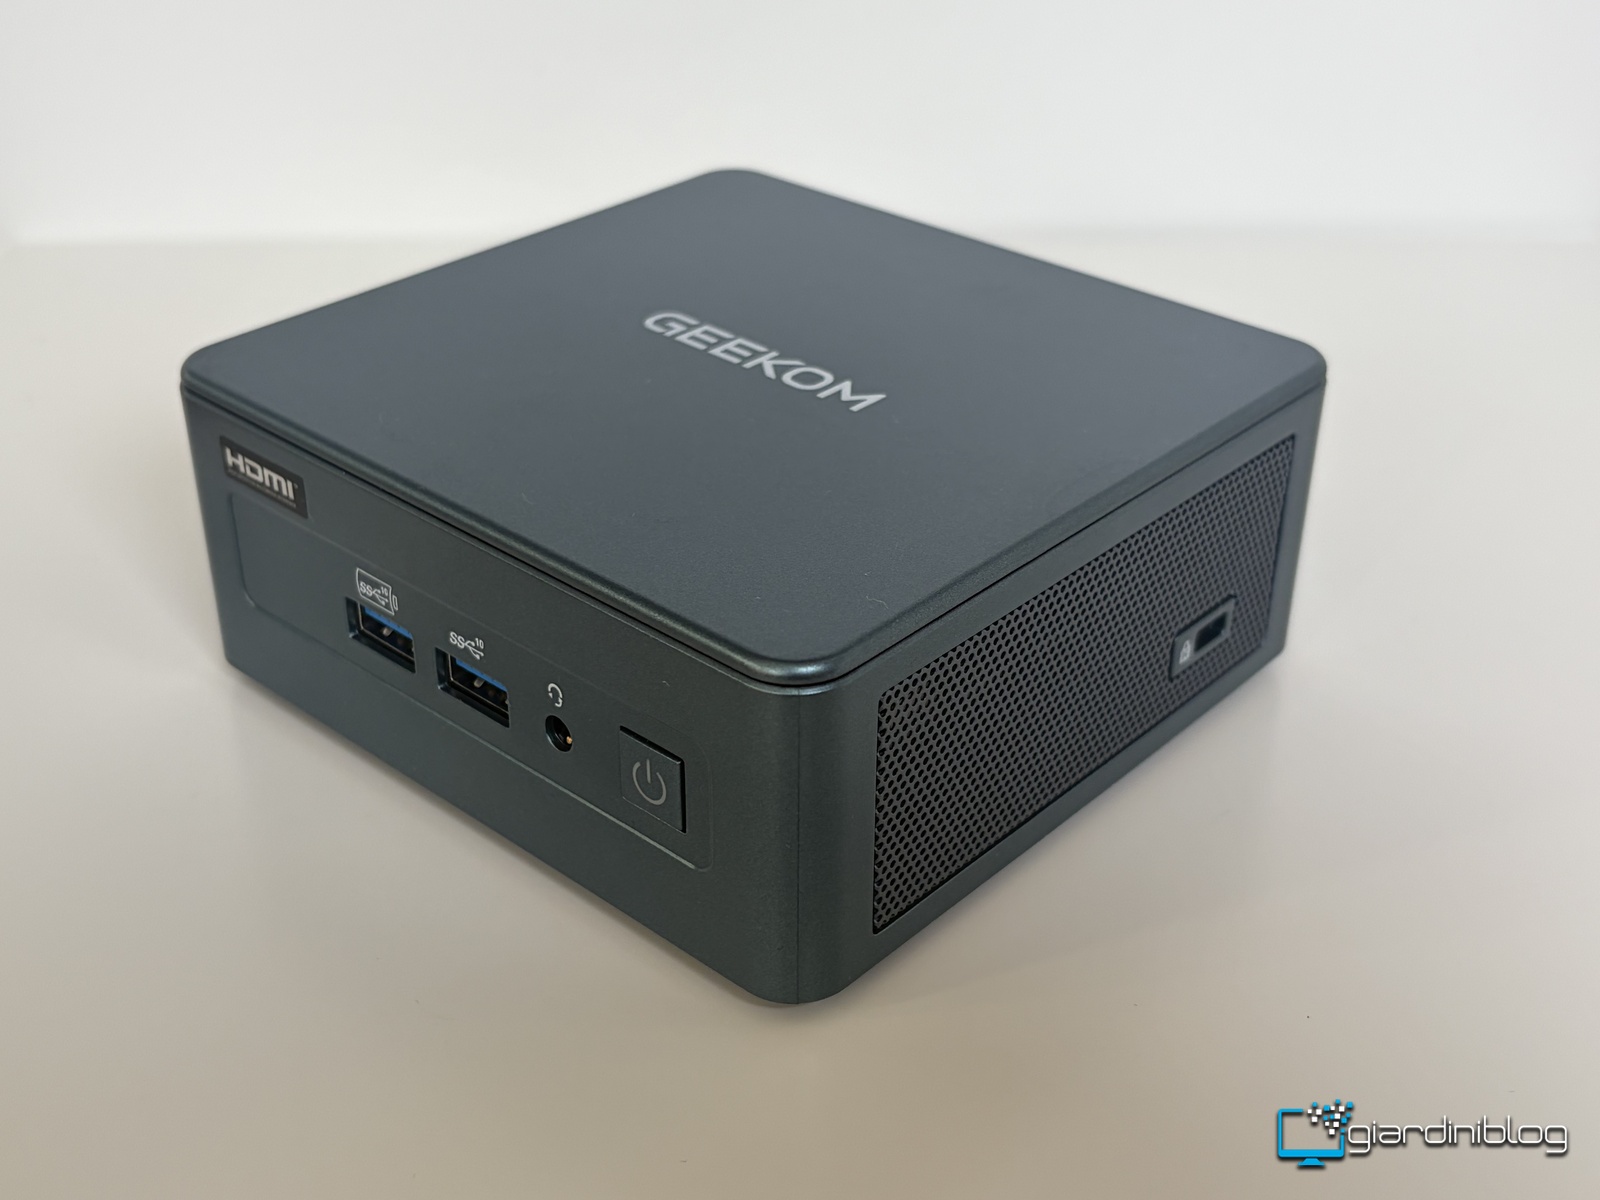
Nella configurazione che abbiamo provato (Core i3-12300HE, 16 GB, 256 GB) il GEEKOM IT12 2026 Edition ha un prezzo di listino di 499 € ma fino al 31 dicembre si può avere a meno. Sullo store ufficiale GEEKOM lo sconto del 7% lo porta a 464 €; su Amazon, con il codice esclusivo che ci è stato dato, ovvero GIA1IT12, scende a 459 €.

GEEKOM IT12 Mini PC con Intel i5-12450H|16GB RAM DDR ESPANDIBILE e 512GB SSD| Windows 11 Pro – LAN 2.5G|6 porte USB| Slot SD – Garanzia 3 Anni – Ideale per Multitasking e Controllo Industriale
Articolo curato da
Giuseppe Alemanno
Founder & Tech Nerd
Vive tra terminali e compilatori. Scrive approfondimenti tecnici, recensioni e tutorial pratici su sistemi operativi, programmazione, hardware e videogiochi.